Technology / Knowledge
AIの価値を、回答の速さではなく、問い・仮説・判断の質につなげる。
情報収集、整理、分析、文書化といった作業はAIで大きく圧縮できます。だからこそ技術設計では、何を検索できるかだけでなく、どの文脈を使って仮説をつくり、誰がどの判断を担い、その結果をどう学習へ戻すかまで設計します。
Agenda → Hypothesis → Evidence → Decision → Action → Learning
Context|知識量ではなく、判断に使える文脈。
NO-MARKが扱うのは、単なる情報の倉庫ではありません。意思決定に使える形で、知識を4つに分けて扱います。
1. 一般知
制度、公的資料、公開情報、一般的な経営・業務知識。
2. 専門知
経営、マーケティング、財務、採用、AI/DX等について、適法に利用可能な専門資料と独自の編集ノート。
3. 企業固有知
社内資料、事業データ、業務ルール、顧客文脈。共有知識とは分離し、利用範囲を管理します。
4. ケース知
実際の相談や実証から得られる、判断の前提、選んだ仮説、結果、成功・失敗条件。次の意思決定に使える形へ抽象化します。
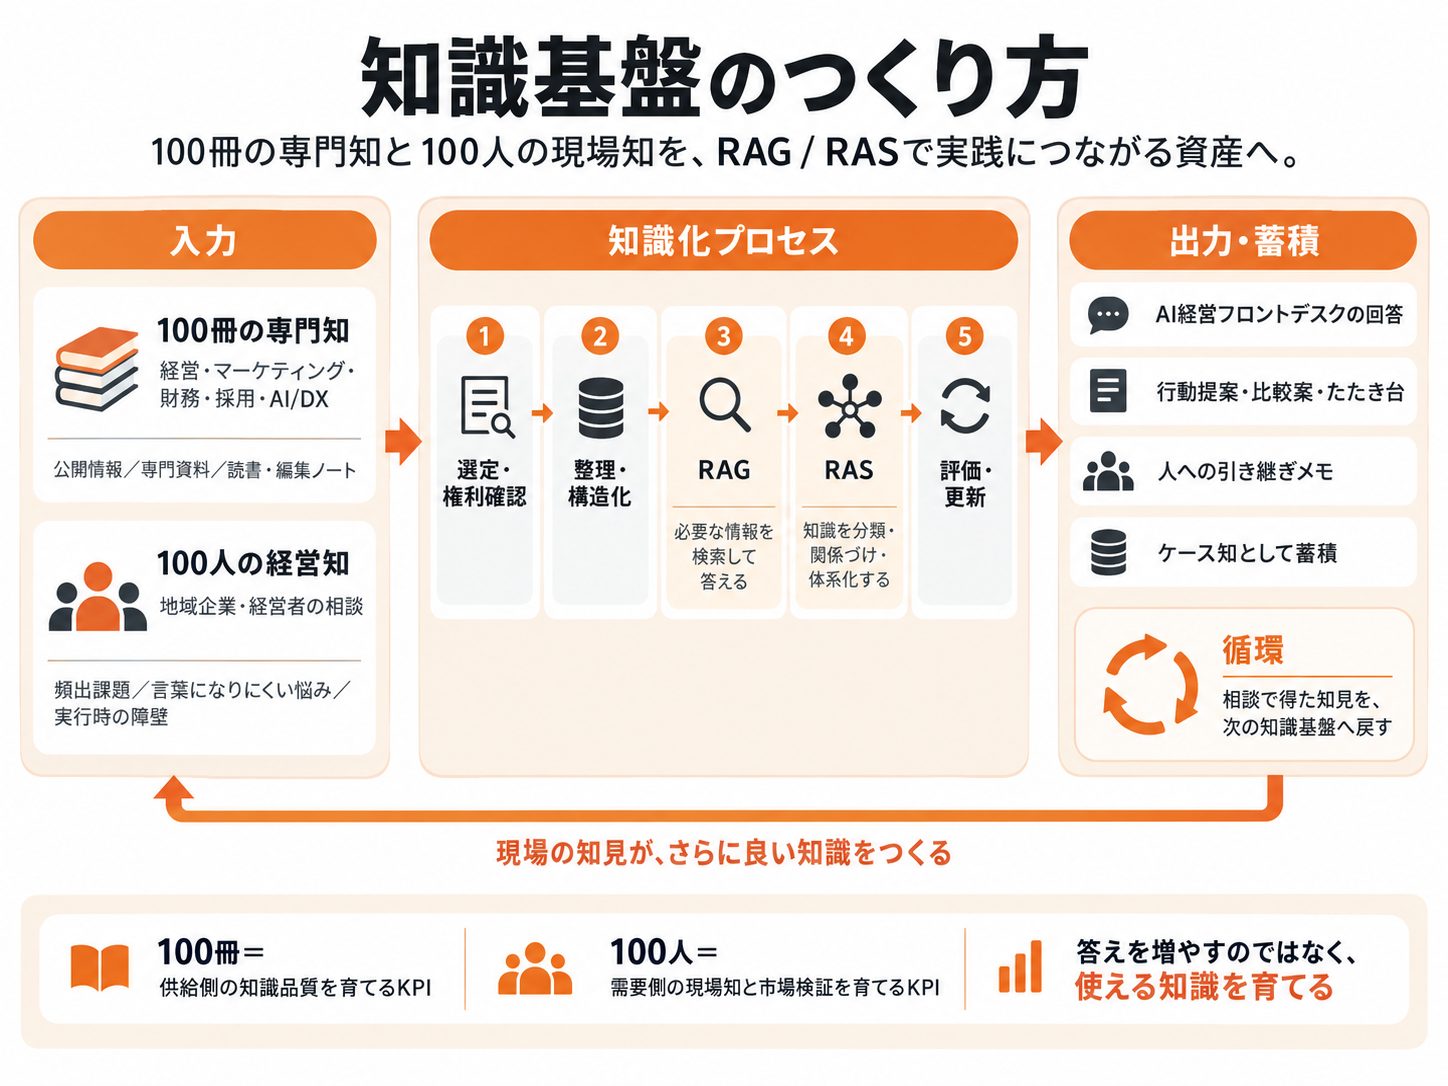
RAG|調べる作業を圧縮する
RAGは、関連する資料を検索し、根拠を参照しながら回答を生成する仕組みです。
ただし、検索できるだけでは事業価値にはなりません。NO-MARKでは、RAGを、仮説検証に必要な根拠を素早く取り出し、判断までの作業コストを下げる層として位置づけます。
RAS|文脈と関係を構造化する
資料を大量に入れても、矛盾、重複、適用条件の違いが整理されていなければ、意思決定には使えません。
そこで、分類、関係、階層、適用条件、判断ポイントなどを整理する層を、Retrieval And Structuring Augmented Generation(RAS)として扱います。
RAGが『必要な情報を取り出す』層なら、RASは『仮説と判断に使える文脈へする』層です。
知識基盤は、仮説と判断の履歴で育つ。
専門資料や公開情報だけでなく、実証で何を仮説とし、何を判断し、結果がどうだったかを知識へ戻します。
Evaluation|『正しい回答』より、『良い判断につながったか』。
- Retrieval:必要な根拠を取り出せたか
- Grounding:根拠と推測を区別できたか
- Hypothesis:検証可能な仮説形成に役立ったか
- Decision:意思決定の質や速度を高めたか
- Boundary:AIが判断すべきでない領域で止まれたか
- Escalation:専門家や責任者へ渡すべき条件を識別できたか
- Learning:結果が次の仮説・運用改善へ戻ったか
Human in the Loop|人を『最終チェック係』にしない。
人の役割は、AIの出力を毎回ゼロから確認することではありません。
何を問題と設定するか、どの仮説を採るか、どの条件で止めるか、誰が責任を負うかを決めることです。AIと人の関係を、作業分担ではなく意思決定と責任の構造として設計します。
Handoff|ブラックボックスではなく、判断能力を残す。
知識基盤は、NO-MARKだけが扱えるものにしません。情報源、更新方法、評価基準、権限、判断ルールをできるだけ明示し、相手側が自ら改善を続けられる形にします。
技術実装のゴールも納品ではなく、次の問いと判断を自分たちで回せる状態です。
100冊 × 100人は、知識量ではなく仮説検証のKPI。
AI経営フロントデスクでは、専門知と現場知を往復させる初期目標として『100冊の専門知 × 100人の経営知』を置いています。
目的は情報量を競うことではありません。専門知が現場の問いに使えるか、現場の違和感から新しい仮説が生まれるかを検証するためです。
データ・権利・モデル
データ分離
共有知識と顧客固有情報を分離し、顧客データを他社向け回答へ無断転用しません。
権利処理
書籍、記事、社内資料は、技術的に取り込めるかではなく利用権限を基準に扱います。
モデル非依存
LLMは性能、価格、セキュリティ、用途に応じて選びます。差別化の中心はモデルそのものではなく、アジェンダ、文脈、評価、権限、ケース知、学習ループに置きます。